Компании всё чаще просят «нейросеть, которая знает наши документы». Ожидания при этом строятся вокруг модели, а работа и риски лежат в подготовке базы. Поэтому мы в студии разбираем RAG как конвейер, а не как магию.
Корпоративный ИИ-ассистент по базе знаний — это чат, который отвечает сотрудникам по документам компании. Сначала он находит в них нужные фрагменты, затем языковая модель формулирует ответ только по найденному и показывает, из какого документа он взят. Такая схема называется RAG (retrieval-augmented generation, генерация с опорой на поиск): модель не «помнит» ваши регламенты, а каждый раз заново их читает.
Что такое RAG простыми словами и почему это не «нейросеть, обученная на документах»
Схему описали в 2020 году исследователи Facebook AI Research и University College London в статье Lewis и соавторов. Они соединили предобученную языковую модель с «непараметрической памятью» — внешним индексом документов. В их экспериментах такие модели генерировали более конкретный и фактологичный текст, чем модели, у которых все знания зашиты внутри. Для нас в этом главный довод в пользу схемы: сама по себе модель оперирует знаниями неточно, поэтому точные знания разумнее держать снаружи, в индексе.
Фраза «обучим нейросеть на ваших документах» описывает другую технологию — дообучение, при котором знания попадают в веса модели. У RAG модель остаётся прежней. Документы лежат в индексе, а модель получает из него несколько подходящих кусков текста вместе с вопросом. Разница кажется технической, но из неё следует почти всё, что важно бизнесу.
- Замена документа: новый регламент достаточно заново проиндексировать, переобучать ничего не нужно.
- Удаление: убрали файл из индекса — ассистент о нём больше не знает.
- Права доступа: индекс может отдавать бухгалтеру одни фрагменты, а стажёру другие. Веса модели так не умеют.
- Цитата: известно, из какого документа взят ответ, и это можно показать пользователю.
Знания лежат в индексе, а не в весах модели. Поэтому качество ассистента определяется прежде всего тем, что и как в этот индекс положили.
Как устроен ассистент: пять звеньев и где каждое ломается
Мы описываем RAG как конвейер. Вопрос сотрудника проходит пять звеньев, и ошибка в любом из них выглядит для пользователя одинаково: «бот ответил неправильно».
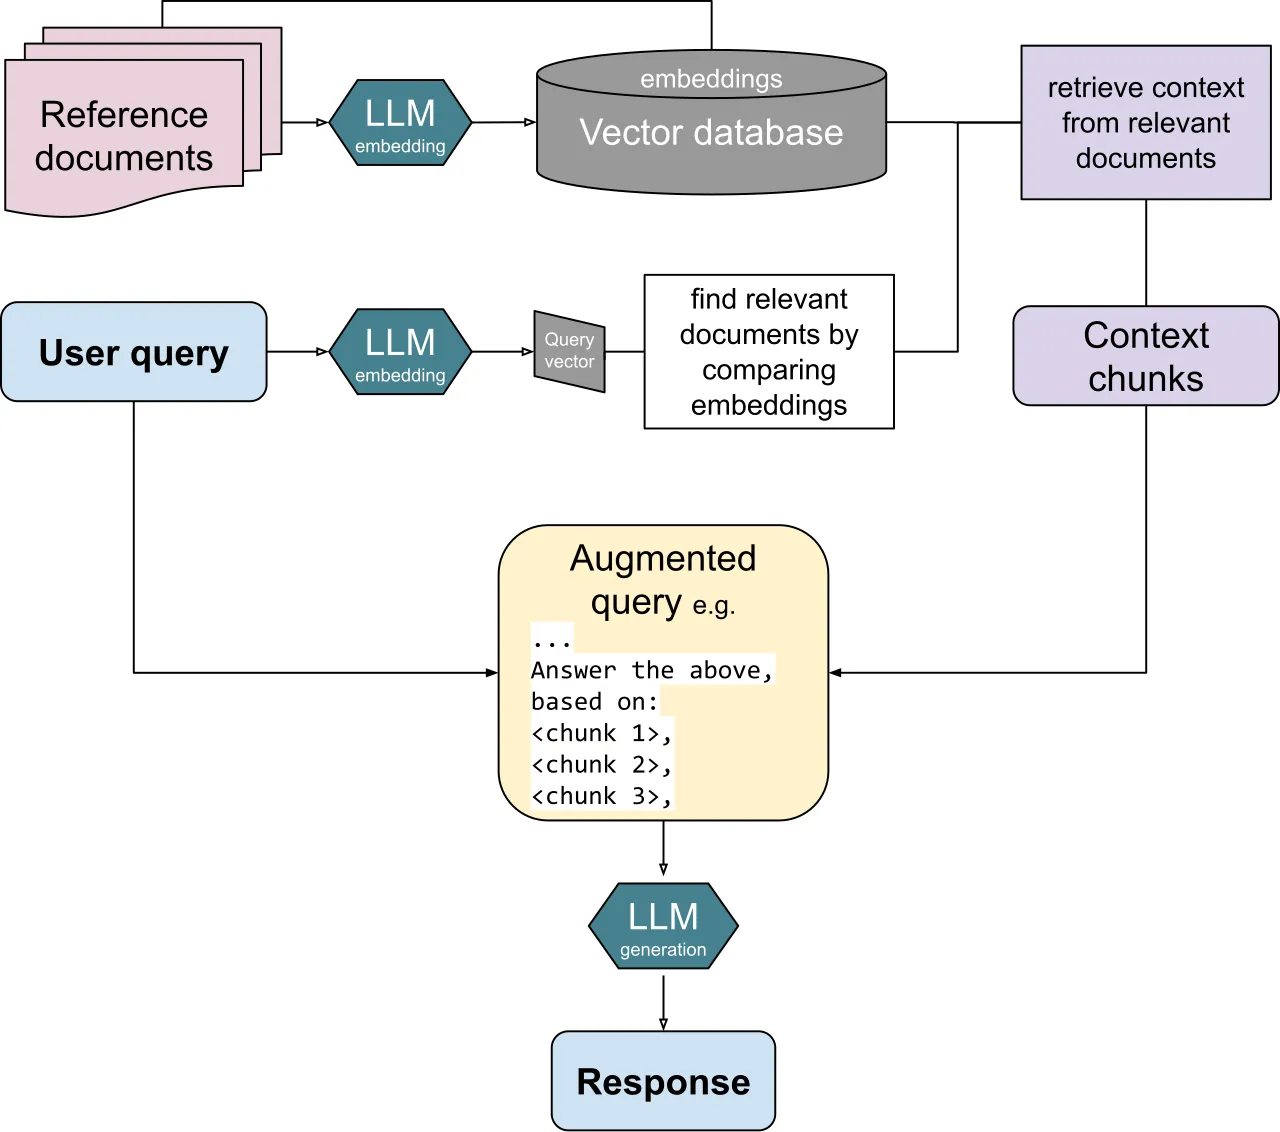
- Подготовка документов: собрать актуальные версии, распознать сканы, превратить таблицы и PDF в текст без потери структуры.
- Нарезка: разбить документы на фрагменты по смыслу — разделами и пунктами, а не каждые N символов — и сохранить у фрагмента заголовок и ссылку на источник.
- Индекс: два поиска сразу — векторный, по смыслу, и обычный, по словам. Векторный справится с вопросом «как оформить отгул», а словарный не промахнётся мимо номера приказа или артикула.
- Поиск и отбор: найти десятки кандидатов, оставить несколько лучших и отсечь те, которые пользователю не положено видеть.
- Ответ: модель формулирует его только по отобранным фрагментам, ставит ссылку на документ и честно говорит «в базе этого нет», если ответа нет.
| Что видит пользователь | Какое звено проверить |
|---|---|
| Ответ по старому регламенту | Подготовка: в индексе несколько версий документа |
| Ошибки в цифрах из таблиц | Подготовка: PDF или скан разобран без структуры |
| Не находит очевидное | Нарезка или индекс: фрагмент разрезан, нет поиска по словам |
| Смешивает два похожих документа | Поиск и отбор: нет переранжирования и метаданных |
| Уверенный ответ на то, чего нет в базе | Ответ: нет правила отказа |
| Сотрудник видит чужие данные | Индекс: поиск идёт без учёта прав доступа |
Когда ассистент ошибается, первая мысль — поставить модель мощнее. Но чаще всего поломка находится раньше: в версиях документов, в разборе таблиц или в нарезке. Более мощная модель получит тот же неверный фрагмент и просто перескажет его убедительнее.
Модель — последнее звено конвейера. Если в него пришёл не тот фрагмент, правильного ответа не будет ни у какой модели.
Чем ассистент по базе знаний отличается от поиска по вики, чат-бота и ИИ-агента
| Инструмент | Что получает сотрудник | Откуда берётся ответ | Кто следит за актуальностью |
|---|---|---|---|
| Поиск по вики | Список страниц | Совпадение слов | Авторы страниц |
| Чат-бот по сценариям | Заготовленный ответ | Сценарий, составленный вручную | Автор сценариев |
| Ассистент на RAG | Связный ответ со ссылкой на документ | Найденные фрагменты документов | Владелец базы знаний |
| ИИ-агент | Ответ и действие в системах | Документы, CRM, учётные системы | Владелец процесса и ИТ |
Поиск по вики оставляет сотруднику самую трудную часть: открыть пять страниц и найти нужный абзац. Чат-бот по сценариям отвечает надёжно, но только на те вопросы, которые кто-то заранее предусмотрел. RAG-ассистент занимает место между ними: понимает вопрос, заданный обычными словами, и отвечает по тексту документов.
Граница с ИИ-агентом простая. Ассистент только отвечает. Агент ещё и действует: создаёт заявку, меняет статус сделки, отправляет сообщение клиенту. Поиск по документам для него — лишь один из инструментов. Если системе нужно что-то делать в ваших программах, требования к правам и проверкам у неё заметно жёстче. Поэтому начинать почти всегда разумно с ассистента.
Где хранить данные: три слоя и три варианта размещения
Вопрос «где хранятся данные» обычно задают так, будто речь идёт об одном месте. На деле у ассистента три слоя, и каждый может жить отдельно.
- Исходные документы — файлы, вики, выгрузки из учётных систем.
- Векторный индекс — нарезанные фрагменты и их числовые представления. Рядом с векторами лежит сам текст фрагментов, иначе ассистенту нечего было бы цитировать. Это копия базы знаний, а не «безобидные числа».
- Модель-генератор — звено, которое получает вопрос с несколькими фрагментами и формулирует ответ. Если модель внешняя, фрагменты уходят к её провайдеру при каждом вопросе.
Часть 5 статьи 18 закона 152-ФЗ не допускает при сборе персональных данных граждан РФ их запись, систематизацию, накопление, хранение, уточнение и извлечение с использованием баз данных за пределами России, кроме нескольких оговорённых в законе случаев. За нарушение требований локализации по ч. 8 ст. 13.11 КоАП предусмотрен штраф до 6 млн ₽, за повторное — по ч. 9 до 18 млн ₽. Технически индекс с фрагментами договоров — такая же база данных. Как закон применяется к вашей схеме, особенно к передаче фрагментов во внешнюю модель, должен оценить юрист по вашему случаю. Задача проекта — заранее показать, какие данные куда текут.
| Вариант | Куда уходят фрагменты | Вход и риск | Кому подходит |
|---|---|---|---|
| Зарубежная модель по API | К провайдеру за рубежом | Дешёвый старт; риск по 152-ФЗ, если во фрагментах есть ПДн | Базам без персональных данных: инструкции, каталог |
| Российское облако, российская модель по API | К провайдеру в России | Оплата по токенам; нужен договор и разбор передаваемых данных | Большинству компаний при обезличенных фрагментах |
| Свой контур, открытая модель на GPU | Не покидают компанию | Дорогой вход в сервер и настройку; ответы обычно слабее облачных | Тем, чьи документы нельзя выносить вовсе |
Слои можно разносить. Частая рабочая схема: документы и индекс остаются на вашем сервере, а наружу при каждом вопросе уходят только несколько фрагментов, предварительно очищенных от персональных данных. Если развернуть всё внутри контура на локальных моделях, наружу не уходит ничего, но качество ответов обычно ниже. Эту разницу стоит увидеть до начала работ, а не после.
Прежде чем выбирать вариант, честно ответьте себе, что в вашей базе знаний считается персональными данными. Чаще всего это:
- договоры и доверенности с ФИО, паспортными данными и адресами;
- кадровые документы: приказы, отпуска, характеристики, зарплатные ведомости;
- переписка с клиентами, выгруженная из почты или мессенджеров;
- выгрузки из CRM с контактами и историей сделок;
- протоколы встреч и служебные записки с именами.
Отдельный вопрос — права доступа. Права проверяются до поиска, а не после ответа. Если индекс сначала ищет по всей базе, а запрещённое отсекают в готовом ответе, модель уже прочитала чужой фрагмент и может пересказать его своими словами. Вдобавок запрещённые фрагменты занимают места в списке найденного и вытесняют разрешённые. Поэтому у каждого фрагмента должна быть метка «кому можно», а поиск должен идти только среди фрагментов, доступных этому пользователю.
Сколько стоит RAG-бот: из чего складывается цена
| Статья | От чего зависит | Как платится |
|---|---|---|
| Подготовка и чистка документов | Число источников, сканы, таблицы, дубли версий | Разово, потом при обновлениях |
| Индекс и права доступа | Есть ли разграничение по отделам и ролям | Разово |
| Интеграции | Мессенджер, портал, CRM, 1С | Разово за каждую систему |
| Токены модели и хостинг | Число вопросов, модель, свой сервер или облако | Ежемесячно |
| Приёмка качества | Размер проверочного набора, требования к точности | Разово и при изменениях |
| Поддержка и обновление базы | Как часто меняются документы | Ежемесячно |
Самая наглядная строка — токены. Посчитаем на допущениях студии: это наш расчёт, а не данные провайдера. База на 10 000 страниц — примерно 10 млн токенов. Эмбеддинги в тарифах GigaChat API для юрлиц стоят 14 ₽ за 1 млн токенов, значит, индексация всей базы обойдётся примерно в 140 ₽. Если мы ошиблись в объёме вдесятеро — около 1 400 ₽.
Один вопрос: инструкция для модели и пять найденных фрагментов — около 3 000 токенов, ответ — около 400, всего примерно 3 400. Нагрузка: 1 000 вопросов в рабочий день, 22 рабочих дня — 22 000 вопросов, или около 75 млн токенов в месяц.
- GigaChat Lite (пакет 1 млрд токенов за 65 000 ₽, или 65 ₽ за 1 млн) — около 4 900 ₽ в месяц.
- GigaChat Pro (пакет 50 млн токенов за 25 000 ₽, или 500 ₽ за 1 млн) — около 37 500 ₽ в месяц; под такую нагрузку на практике подойдёт пакет 80 млн за 40 000 ₽.
- Отдел на 100 вопросов в день — всё делится на десять: около 500 ₽ на Lite и около 3 750 ₽ на Pro по цене за токен.
Мы считали по пакетным тарифам для юрлиц на ноябрь 2026 года. Тарифы меняются, а пакет на миллиард токенов при такой нагрузке расходуется больше года, поэтому условия пакетов и режим оплаты нужно сверить перед сметой.
Токены обходятся в тысячи рублей, дорого стоит работа людей. Разобрать сотню PDF со сканами и таблицами, вычистить старые версии, расставить метки доступа, собрать проверочный набор — вот на что уходят деньги и время. Отсюда и разброс цен «на RAG» от десятков тысяч до миллионов рублей: под одним словом продают очень разные проекты. Цену двигают четыре вещи:
- число источников — одна папка с регламентами или вики, почта, CRM и файловый сервер;
- наличие прав доступа — одна база для всех или разграничение по ролям;
- интеграции — окно на сайте или ассистент внутри портала, мессенджера и учётной системы;
- требования к точности — справочник для сотрудников или ответы, по которым принимают юридически значимые решения.
Расходы на серверы и обращения к моделям — отдельная ежемесячная строка. Её стоит считать под ожидаемую нагрузку и показывать в смете заранее, а не выяснять по первому счёту.
Если в смете почти вся сумма приходится на модель, а на подготовку документов и приёмку — почти ничего, смета составлена наоборот.
Как проверить качество ассистента до запуска
Фраза «бот отвечает хорошо» ничего не значит, пока не сказано, на каких вопросах это проверяли. Проверочный набор мы собираем до того, как ассистент увидит первого пользователя.
- Соберите 30–50 реальных вопросов сотрудников из рабочих чатов, почты и обращений в поддержку, а не придуманных разработчиком.
- Запишите к каждому эталонный ответ и документ с пунктом, где этот ответ находится.
- Добавьте 5–10 вопросов, ответа на которые в базе нет.
- Добавьте вопросы от имени сотрудника без доступа к нужному документу.
- Прогоните набор и отметьте по каждому вопросу четыре вещи: нашёл ли ассистент нужный фрагмент, верен ли ответ, указан ли источник, отказался ли он там, где должен.
Четыре отметки нужны раздельно, потому что они указывают на разные звенья. Не нашёл фрагмент — проблема в подготовке, нарезке или индексе. Нашёл, но ответил неверно — в инструкции модели. Ответил на вопрос, ответа на который в базе нет, — нет правила отказа.
О критерии готовности договариваются заранее, а не после демонстрации. Наш минимум: на вопросах без ответа ассистент отказывается всегда, ни один ответ не опирается на документ, закрытый для этого пользователя, источник указан в каждом ответе, а доля верных ответов не ниже согласованной. Если уверенности нет, ассистент говорит, что не знает, и передаёт вопрос человеку.
Эталонный набор должен вести владелец знаний — руководитель отдела или тот, кто отвечает за регламенты, а не ИТ. Только он знает, какой ответ правильный. После запуска набор не выбрасывают: его прогоняют после каждого крупного обновления базы.
Какие ошибки делают чаще всего
- Всё подряд в индексе. Черновики и старые версии спорят с действующими документами. Заметно по ответам «по старому регламенту»; лечится отбором источников и правилом «в индекс — только утверждённое».
- Отсутствие владельца базы. Через три месяца документы устаревают, а ассистент продолжает уверенно на них ссылаться. Помогает назначение ответственного и регулярное обновление.
- Права доступа «потом». Первый же ответ с чужой зарплатой подрывает доверие ко всей системе. Метки доступа закладываются при индексации, а не после жалобы.
- Ответ без цитаты. Сотрудник не может проверить ответ и либо слепо верит, либо всё перепроверяет вручную. Ссылка на документ и пункт должна быть обязательной частью ответа.
- Запуск без проверочного набора. О качестве судят по пяти удачным вопросам на демонстрации. Лечится набором из 30–50 вопросов с эталонами до запуска.
- Ставка на самую большую модель. Дорогая модель не исправит разрезанную таблицу и дубль регламента. Сначала чинят подготовку документов, потом выбирают модель.
Частые вопросы
RAG или дообучение? Для ответов по документам компании почти всегда RAG: документы меняются, а дообученную модель пришлось бы переобучать. Дообучение уместно, когда нужно изменить стиль или формат ответов, а не добавить знания.
Можно ли обойтись без интернета и зарубежных сервисов? Да: документы, индекс и открытая модель разворачиваются на вашем сервере. Цена такого решения — дорогое железо на входе и ответы, как правило, слабее, чем у крупных облачных моделей.
Сколько документов нужно? Столько, сколько отвечает на реальные вопросы одного отдела. Десяток актуальных регламентов полезнее тысячи файлов, среди которых половина устарела.
Уйдут ли документы «в нейросеть»? Модель не запоминает ваши документы и не учится на них. Но при внешней модели фрагменты передаются провайдеру при каждом вопросе, поэтому важно, где он находится и что именно ему отправляют.
Сколько делать пилот? Зависит от состояния документов, числа источников и интеграций. Пилот на одном отделе с одной папкой регламентов заметно короче проекта с правами доступа и несколькими системами, а больше всего времени обычно съедают сканы и дубли версий.
Кто будет обновлять базу? Владелец знаний со стороны компании — тот же человек, что ведёт эталонный набор. Если загрузка и замена документов устроены через понятный интерфейс, программист для повседневной работы не нужен; разработчик понадобится, когда подключают новые источники.
Что из этого следует на практике
Начинать стоит не с «ИИ на всю компанию», а с одного отдела и 30–50 вопросов, которые там задают каждую неделю. Такой пилот быстро показывает, в каком состоянии документы, сколько в них персональных данных и нужны ли права доступа. А это и есть три главные статьи будущей сметы.
Решение о размещении принимается до выбора модели, а не после. Сначала — какие данные в базе и куда их можно передавать, потом — какая модель доступна в этом контуре. Обратный порядок заканчивается тем, что прототип на зарубежной модели нравится всем, но запустить его нельзя.
Иногда разбор показывает, что нейросеть не нужна вовсе: если вопросы формализуются правилами, обычная автоматизация надёжнее и дешевле. О том, как мы проектируем ассистентов и где проходит эта граница, — на странице AI и автоматизации.
Хороший корпоративный ассистент похож не на всезнающего собеседника, а на аккуратного библиотекаря: знает, где лежит нужная страница, показывает её и не выдумывает того, чего на полках нет. Всё ценное в нём сделано до того, как модель сформулировала первое слово.
Источники
- Lewis et al. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (arXiv, 2020)
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks — страница статьи на Hugging Face
- 152-ФЗ «О персональных данных», статья 18 — КонсультантПлюс
- Штраф за локализацию персональных данных (ст. 13.11 КоАП РФ) — КонсультантПлюс
- Тарифы GigaChat API для юрлиц
- GigaChat: модели Embeddings